Synology NAS에 Container Manager를 설치하고 Docker 컨테이너를 하나 띄우는 것 자체는 어렵지 않다.
운영이 어려워지는 시점은 그 다음이다.
이미지를 업데이트했더니 설정이 사라지고, 컨테이너를 다시 만들었더니 데이터가 없어지고, 몇 달 뒤에는 어떤 폴더를 백업해야 하는지 알 수 없게 되는 순간부터 Docker는 편리한 앱 실행기가 아니라 복구하기 어려운 운영환경이 된다.
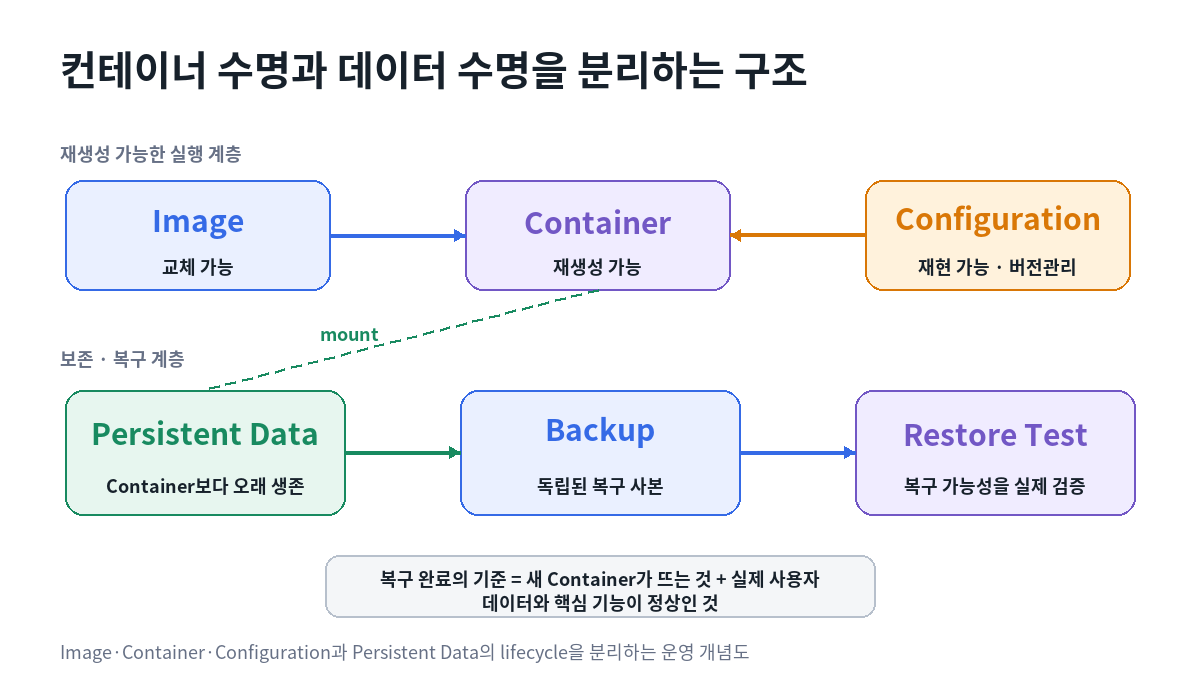
핵심은 하나다. 컨테이너의 수명과 데이터의 수명을 분리해야 한다.
컨테이너는 서버 자체가 아니라 교체 가능한 실행 인스턴스다
Docker에서는 container를 영구적인 서버처럼 취급하지 않는 편이 좋다.
컨테이너는 image와 configuration을 이용해 다시 만들 수 있는 실행 인스턴스다.
따라서 컨테이너 안에만 중요한 데이터를 저장하면 update나 recreate가 곧 데이터 리스크가 된다.
운영관점에서는 다음 네 가지를 분리해야 한다.
| 구성요소 | 역할 | 수명 |
|---|---|---|
| Image | 애플리케이션 실행파일과 기본환경 | 버전별 교체 가능 |
| Container | Image를 실제 실행한 인스턴스 | 언제든 재생성 가능 |
| Configuration | 환경변수·Compose·설정 | 버전관리 대상 |
| Persistent Data | DB·업로드·사용자 데이터 | 컨테이너보다 오래 살아야 함 |
Synology의 Project는 단순 GUI 폴더가 아니다
현재 Synology Container Manager의 Project 기능은 Compose 파일을 이용해 여러 컨테이너를 하나의 애플리케이션 단위로 생성하고 운영할 수 있게 한다.
예를 들어 WordPress라면:
- Web application
- Database
- Cache
를 하나의 Project로 묶을 수 있다.
이렇게 하면 컨테이너 하나씩 수동으로 만든 환경보다 전체 구성을 재현하기가 쉽다.
하지만 Compose를 쓴다는 사실만으로 복구 가능성이 자동으로 생기는 것은 아니다.
Compose 파일 밖에 존재하는 실제 데이터 위치와 secret까지 함께 관리해야 한다.
가장 먼저 결정할 것은 데이터가 어디에 남을 것인가다
DB를 예로 들어보자.
MariaDB container 내부의 기본 data directory에만 데이터가 있고 외부 persistent storage가 연결되지 않았다면 container를 삭제하거나 recreate할 때 데이터가 사라질 수 있다.
그래서 운영 DB는 일반적으로:
Container → persistent volume 또는 host bind mount → NAS filesystem
형태로 분리한다.
애플리케이션 container가 몇 번 바뀌더라도 DB 파일의 lifecycle은 별도로 유지되는 구조다.
Bind Mount와 Named Volume은 목적을 알고 선택한다
두 방식의 차이는 단순히 Docker 문법의 취향 문제가 아니다. 운영자가 데이터 위치를 어떻게 추적하고, 백업과 마이그레이션에서 무엇을 복구단위로 삼을지에 영향을 준다. 따라서 선택 기준은 “어느 쪽이 더 고급인가”가 아니라 데이터 위치와 lifecycle을 운영자가 끝까지 설명할 수 있는가다.
둘 중 하나가 무조건 우월한 것은 아니다.
Bind Mount
NAS의 실제 경로가 명확하게 보인다.
예를 들어:
/volume1/docker/app/data
같은 위치를 container의 데이터 경로에 연결할 수 있다.
장점은 DSM, backup job, shell에서 실제 파일 위치를 쉽게 확인할 수 있다는 것이다.
반면 host path 구조와 permission을 운영자가 직접 관리해야 한다.
Named Volume
Docker가 volume 위치와 lifecycle을 관리한다.
Compose 파일이 간결해질 수 있지만 실제 데이터가 NAS에서 어디에 존재하는지 운영자가 이해하지 못하면 backup·migration 시 혼란이 생길 수 있다.
어떤 방식을 쓰든 핵심은 데이터 위치가 문서화되고 실제 backup 대상에 포함돼 있어야 한다는 것이다.
Container Manager의 Clean은 운영에서 특히 조심해야 한다
Synology 공식 Project 관리기능에서 Clean은 project의 container를 중지하고 Compose에 의해 생성된 container, network, volume, image 등을 제거할 수 있다.
개발환경에서는 편리하지만 production data가 Docker-managed volume에 있고 그 lifecycle을 정확히 이해하지 못한다면 위험할 수 있다.
따라서 버튼 이름보다 먼저 질문해야 한다.
이 Project를 완전히 지워도 다시 만들 수 있는 것과 절대 지우면 안 되는 것은 무엇인가?
운영 디렉터리는 세 층으로 나누면 관리가 쉬워진다
한 가지 실용적인 구조는 다음과 같다.
application/
  compose.yaml
  config/
  data/
  backup/
물론 실제 경로와 세분화 방식은 환경에 따라 달라질 수 있다.
중요한 것은 역할이다.
- compose.yaml: 서비스를 재현하는 선언
- config: 애플리케이션 설정
- data: DB·업로드 등 persistent state
- backup: 운영 data와 분리된 복구용 사본
이 구조를 지키면 “어떤 container가 떠 있는가”보다 “어떤 상태를 보존해야 하는가”가 명확해진다.
Secret을 Compose 안에 직접 넣으면 백업과 공유가 어려워진다
DB password나 API token을 Compose 파일 안에 그대로 적으면 파일을 백업·공유·버전관리할 때 secret까지 따라다닌다.
운영환경에서는:
- Compose
- 일반 configuration
- credentials/secrets
를 분리하는 편이 좋다.
특히 backup 파일이나 troubleshooting 결과에 secret이 출력되지 않도록 해야 한다.
Image tag는 편리함과 재현성의 trade-off다
latest tag는 새 버전을 쉽게 가져올 수 있지만 어느 날 rebuild했을 때 어제와 다른 binary가 실행될 수 있다.
반대로 정확한 version이나 digest를 고정하면 재현성은 높아지지만 업데이트를 직접 관리해야 한다.
Production에서는 최소한:
- 현재 image 이름과 버전
- 업데이트 전 버전
- 업데이트 날짜
- database migration 여부
를 추적하는 편이 안전하다.
Update는 Pull보다 먼저 rollback 가능성을 본다
컨테이너 update를 다음처럼 생각하면 위험하다.
새 image pull → restart → 끝
실제 운영에서는 다음 순서가 더 안정적이다.
- 현재 image/config/data 상태 확인
- Release note와 breaking change 확인
- 필요한 persistent data backup
- 새 image 적용
- Health check와 주요 기능 확인
- 문제가 있으면 이전 image/config로 복귀
특히 database schema migration이 포함된 애플리케이션은 image만 이전 버전으로 내린다고 복구되지 않을 수 있다.
Backup은 Container를 저장하는 일이 아니다
실제로 필요한 것은 container 자체보다 다음이다.
- Compose/configuration
- Persistent application data
- Database backup 또는 일관성 있는 DB data
- 필요한 secret의 안전한 복구수단
Image는 registry에서 다시 받을 수 있는 경우가 많다.
반대로 사용자 데이터와 DB는 외부에 사본이 없다면 다시 만들 수 없다.
복구테스트는 새 Container를 띄우는 것으로 끝나지 않는다
좋은 복구테스트는:
- 새 container 생성
- 기존 persistent data 연결 또는 restore
- 애플리케이션 정상 시작
- 실제 사용자 데이터 존재 확인
- 로그인·DB query·업로드 등 핵심 기능 검증
까지 수행한다.
백업 파일이 존재한다는 것과 서비스가 복구된다는 것은 다른 상태다.
결론
Synology Container Manager에서 중요한 것은 컨테이너를 많이 실행하는 기술이 아니다.
Image는 교체 가능하게, Container는 재생성 가능하게, Configuration은 재현 가능하게, Data는 독립적으로 보존 가능하게 만드는 것이 핵심이다.
이 네 층이 분리돼 있으면 update와 장애복구가 단순해진다.
반대로 container 안에 설정과 데이터를 함께 쌓아두면 시간이 지날수록 시스템은 동작하지만 아무도 안전하게 다시 만들 수 없는 상태가 된다.
Docker 운영의 완성도는 컨테이너가 얼마나 오래 살아 있었는지가 아니라 오늘 전부 지우고도 의도한 상태로 다시 만들 수 있는가로 판단하는 편이 정확하다.